

Faites en sorte que chaque exécution d'agent d'IA compte.
Lematev se place entre vos agents et les fournisseurs de modèles. Il décide du modèle dont chaque appel a réellement besoin, refuse ceux qui ne mènent nulle part, et découpe la facture par agent et par tâche.
Une couche, au-dessus de tous
 OpenAI
 Anthropic
 Google
 Groq
 Mistral
 DeepSeek
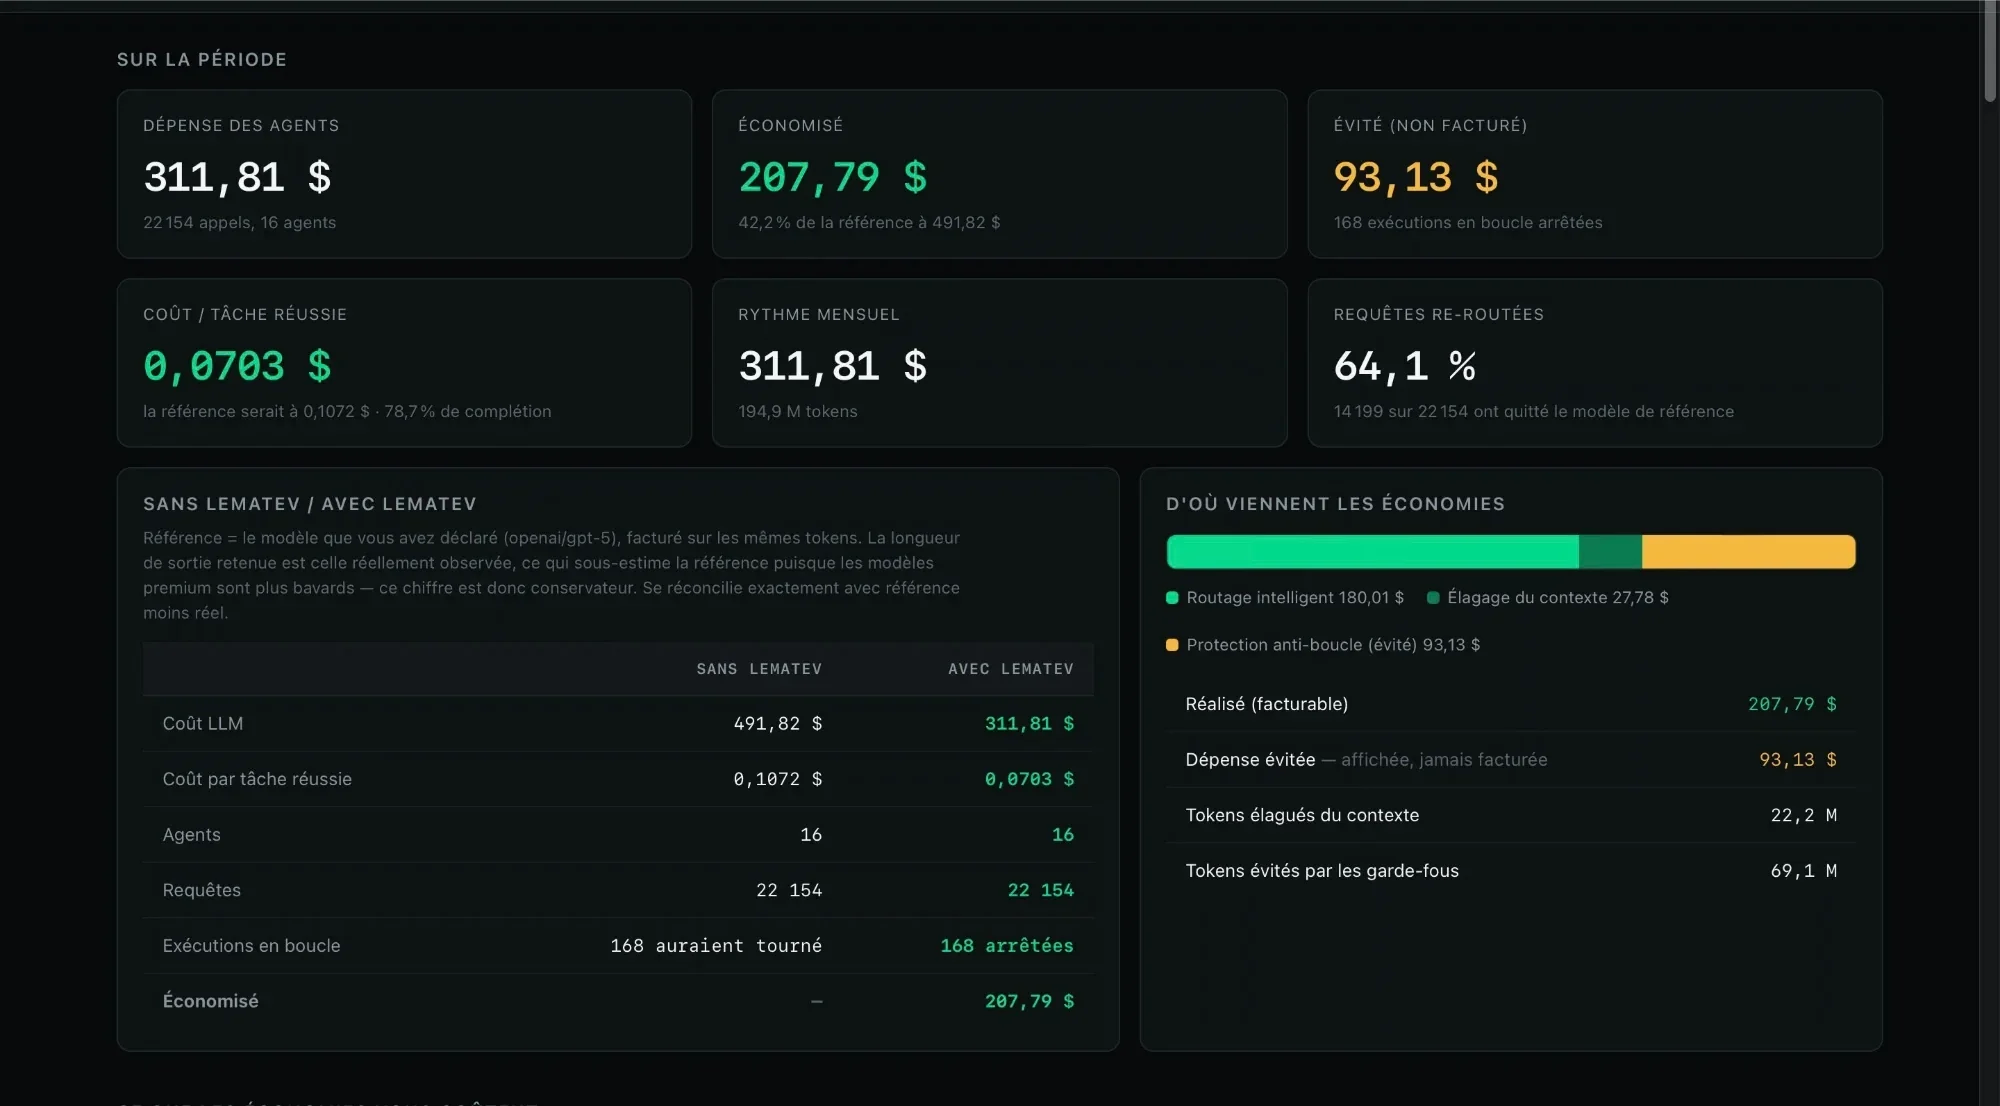
Votre dépense, ce qu'elle aurait coûté sans nous, et ce que les économies coûtent en taux de complétion — par agent et par tâche. Chaque chiffre est calculé par le moteur à partir de votre propre trafic.
Qu'est-ce que le contrôle de coût pour agents IA ?
C'est piloter la dépense que crée un système agentique — appels d'outils, retries, boucles et tâches multi-étapes qui multiplient les requêtes de façon imprévisible. La plupart des outils lisent les données de facturation de votre fournisseur et vous alertent une fois l'argent parti. Lematev se place dans le chemin de la requête, ce qui lui permet de refuser un appel au lieu de le rapporter.
Agent, modèle, tâche — trois choses différentes
On emploie ces mots l'un pour l'autre, et ça rend le coût impossible à discuter. Voici ce que chacun désigne.
Un modèle, c'est ce qui vous facture
GPT-5, Claude, llama-3.3 sur Groq. Vous lui envoyez du texte, il en renvoie, et il facture au token. Il n'a aucune mémoire de votre produit et aucune idée de la tâche dont il fait partie.
Un agent, c'est votre code
La boucle que vous avez écrite, qui appelle un modèle plusieurs fois, utilise des outils et tente de finir un travail. « support-triage » est un agent. Votre fournisseur n'en a jamais entendu parler — et c'est exactement pour ça que votre facture ne peut pas vous dire ce qu'il coûte.
Une tâche, c'est une tentative sur un travail
Un ticket trié, un document extrait. Cela prend en général plusieurs appels au modèle. C'est la seule unité qui ait un sens pour votre métier, et la seule que personne ne mesure.
La dépense modèle, pilotée au niveau de l'agent et de la tâche. L'argent part sur un appel au modèle ; la décision de savoir si cet appel valait le coup appartient à l'agent. Contrôler l'un sans voir l'autre, c'est pour ça que les factures d'IA paraissent aléatoires.
Basculez entre ce à quoi ressemble votre installation aujourd'hui et ce à quoi elle ressemble avec Lematev dans le chemin. Les chiffres des puces sortent du moteur.
Vos agents
Fournisseurs de modèles
Votre fournisseur facture par clé. Vos coûts arrivent par agent.
Une ligne sur la facture pour douze agents. Personne dans l'entreprise ne peut dire lequel coûte quoi — c'est pour ça qu'une facture d'IA paraît aléatoire plutôt que chère.
Un retry qui n'aboutit jamais est indistinguable du trafic normal, jusqu'à l'arrivée de la facture.
Lire la facture, ou se mettre en travers
Les outils de coût se placent à deux endroits, et l'endroit décide de ce qu'ils peuvent faire face à un agent emballé.
| Outils en lecture seule | Lematev |
|---|
La dernière ligne est à leur avantage, pas au nôtre. Si vous voulez seulement savoir, un outil en lecture seule vous demande moins. Si vous voulez que ça s'arrête, il faut bien que quelque chose soit en travers.
Trois étapes, environ dix minutes
Changez une ligne
Pointez votre client sur Lematev au lieu de votre fournisseur. Même forme de requête, même forme de réponse. Rien d'autre ne bouge dans votre code.
Nommez vos agents
Ajoutez un en-tête avec le nom de votre choix. C'est ce nom qui sert de regroupement dans le tableau de bord — aucune configuration par agent, aucune intégration à construire. Un agent apparaît dès son premier appel.
Déclarez ce qu'un échec vous coûte
« Un triage de ticket raté me coûte 3 € de traitement humain. » À partir de là, le routage suit l'arithmétique et non notre opinion.
# before
client = OpenAI(api_key=OPENAI_KEY)

# after
client = OpenAI(
    base_url="https://gw.lematev.dev/v1",
    api_key=LEMATEV_KEY,
)
Pourquoi notre routage n'est pas juste « prends le modèle pas cher »
La plupart des routeurs choisissent le modèle le moins cher qui passe une barre de qualité. Nous avons construit ça d'abord et nous l'avons mesuré sur 41 364 appels d'agents : 2,2 % d'économies, en baisse semaine après semaine. Une barre traite tous les appels d'une exécution comme aussi critiques, et c'est faux — rater un appel d'outil coûte un retry, rater la réponse finale coûte la tâche entière.
Les modèles bon marché prennent le travail récupérable, les modèles forts le travail pivot, et la politique s'améliore à mesure que les preuves s'accumulent au lieu de s'effondrer sur un seul modèle. Sur la même charge : 42 % d'économies, 2,3 points de complétion cédés, 34 % de mieux sur le coût par tâche réussie.
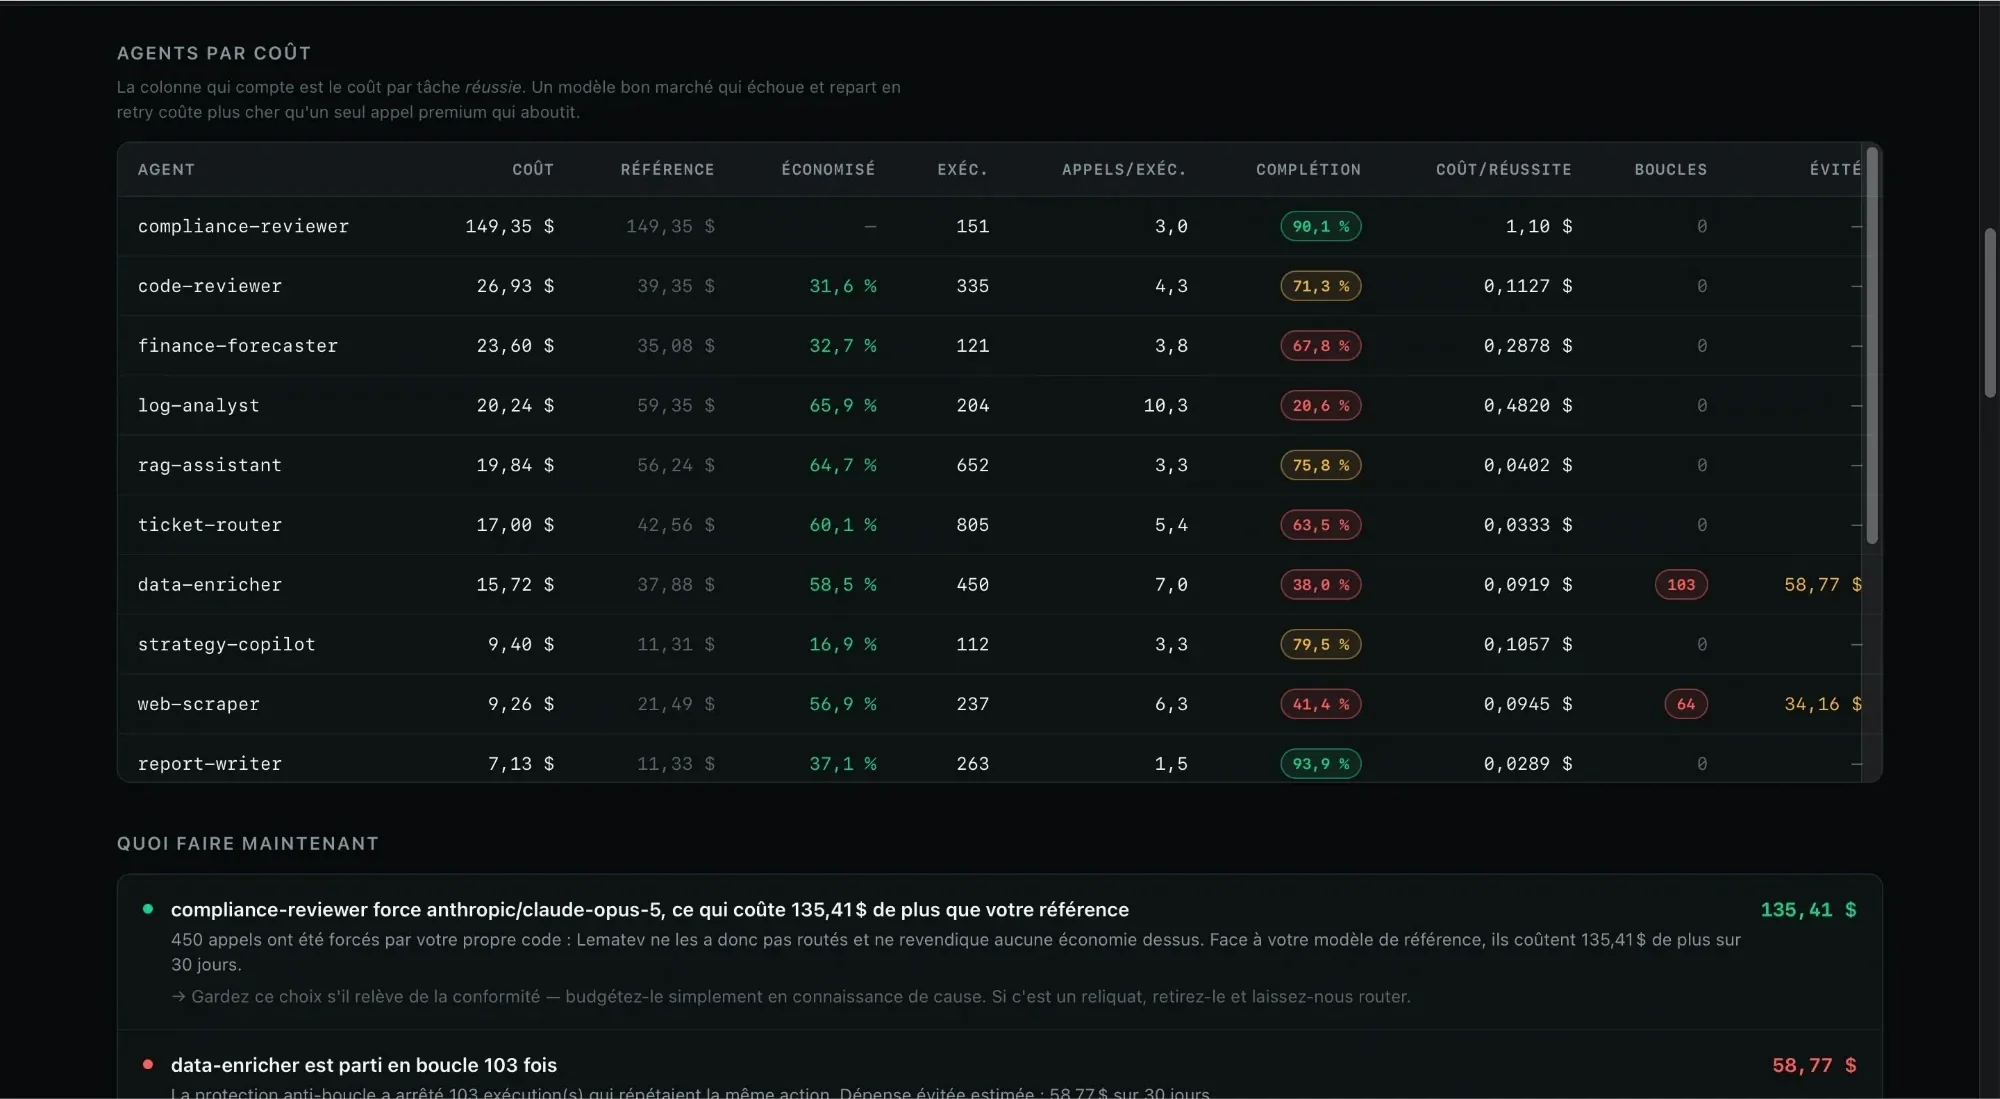
Votre facture dit 4 218 $. Elle ne dit pas quel agent.
Une ligne par agent, et une colonne qui compte : le coût par tâche réussie. Un modèle bon marché qui échoue et repart en retry coûte plus cher qu’un seul appel premium qui aboutit.
Les badges rouges sont des exécutions que le garde-fou a arrêtées avant qu’elles ne dépensent davantage.
Conçu pour les équipes dont les agents sont déjà en production
-
Les produits qui font tourner plusieurs agents avec une seule ligne de facture.
-
Les équipes dont les agents appellent des outils, réessaient, et bouclent parfois toute la nuit.
-
Ceux qui dépensent plus de quelques milliers d'euros par mois en appels modèles.
-
Les cabinets qui doivent montrer à un client quel agent a coûté quoi.
L’écart se creuse à mesure que le trafic grandit
Trente jours, les mêmes appels facturés deux fois : la ligne pointillée, c’est ce que le modèle déclaré aurait coûté ; la ligne pleine, ce que le routeur a réellement dépensé.
Comment vous savez que les économies sont réelles
Nous vous demandons de croire un chiffre que nous seuls pouvons calculer. Nous l'avons donc rendu vérifiable de trois façons différentes.
- Il se réconcilie à l'écranL'économie affichée est égale à votre dépense de référence moins votre dépense réelle, sur la même page. Il existe un champ d'écart et un test qui échoue si ce chiffre bouge.
- La méthodologie est publiéeRéférence = le modèle que vous avez déclaré, facturé sur les tokens que vous avez réellement envoyés. Nous retenons la longueur de sortie observée, ce qui sous-estime la référence puisque les modèles premium sont plus bavards — le chiffre est donc conservateur par construction.
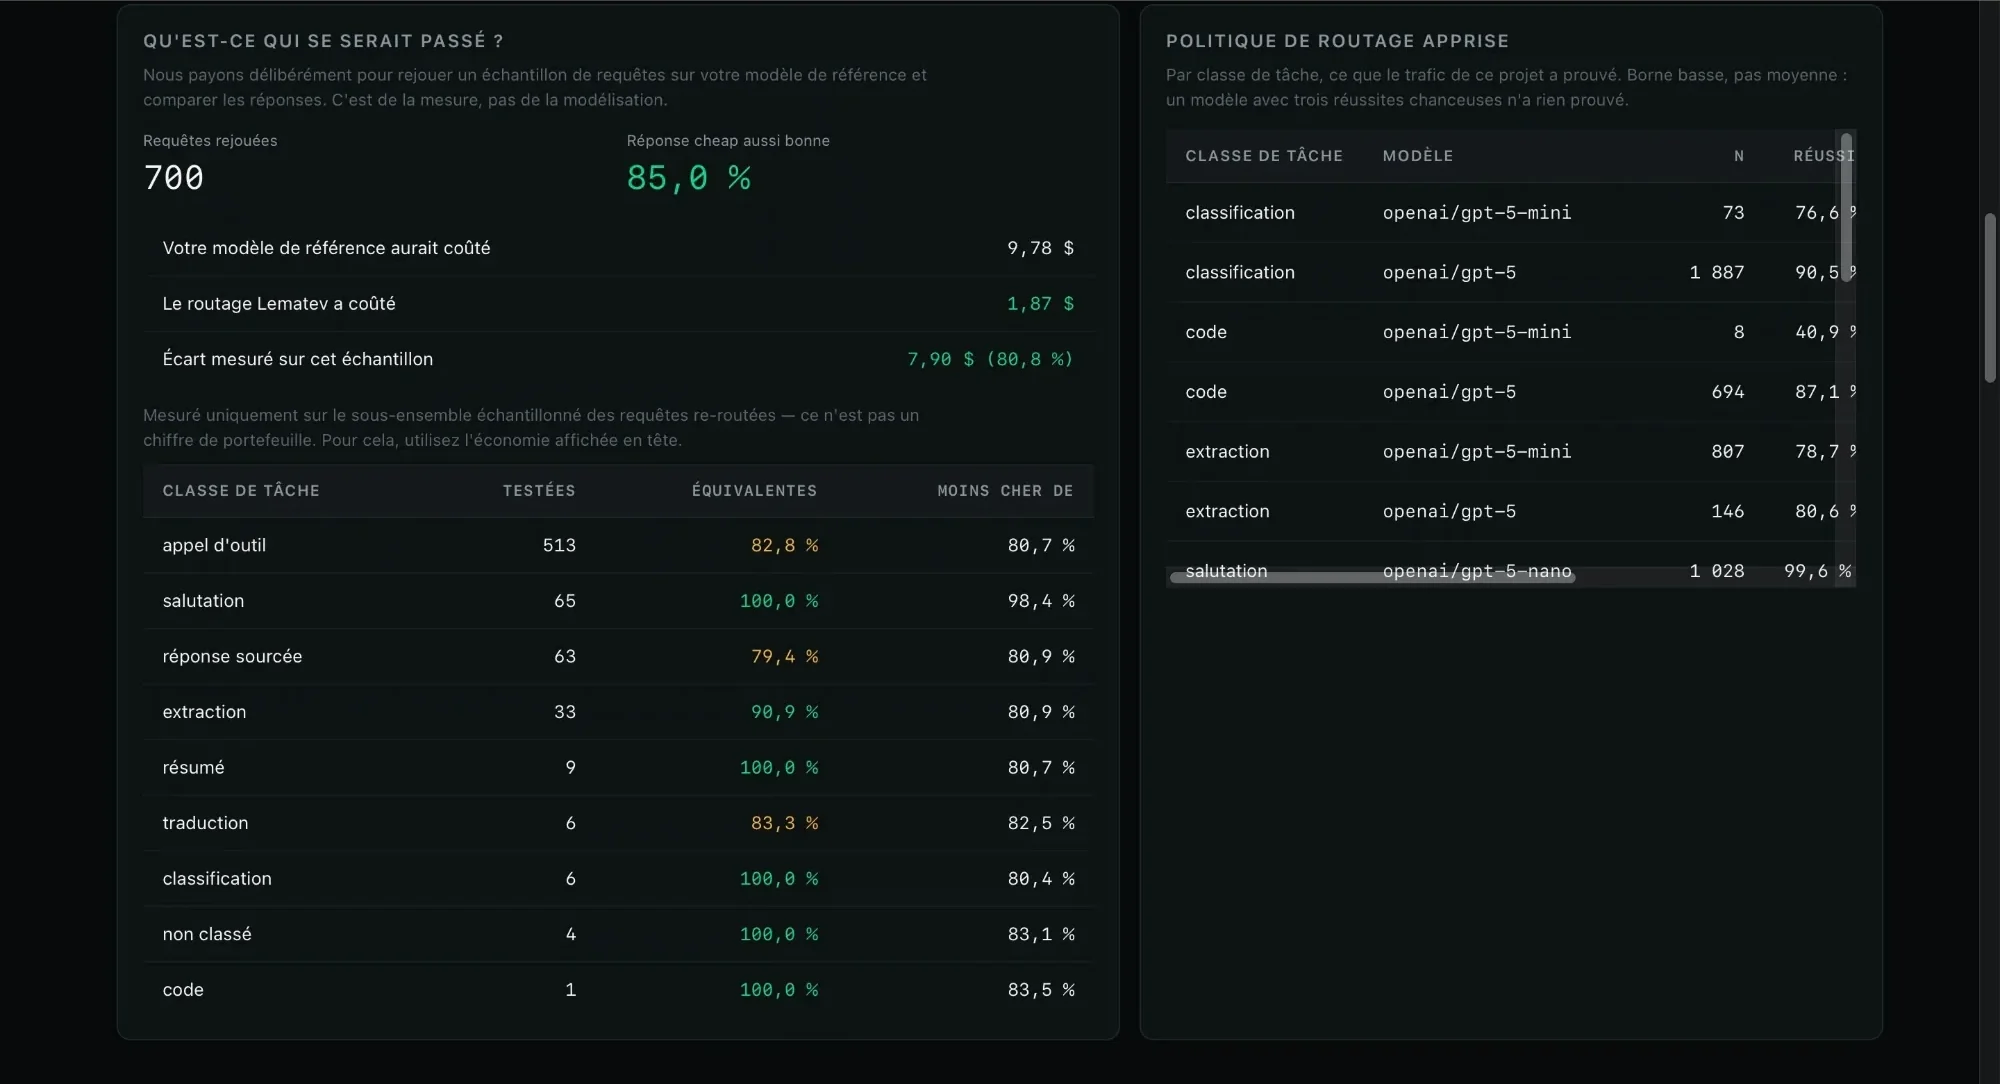
- Mesuré, pas modéliséUn échantillon de vos requêtes re-routées est rejoué sur votre modèle d'origine et les réponses sont comparées. Cela nous coûte de l'argent volontairement, et transforme « faites-nous confiance » en preuve que vous pouvez lire.
- Nous excluons ce que nous ne pouvons pas défendreLe gaspillage évité en arrêtant un agent emballé est affiché mais jamais compté comme une économie. Les appels où votre propre code a forcé un modèle sont exclus entièrement — c'était votre décision, pas la nôtre.
Les questions qu'un CTO pose vraiment
Faites en sorte que chaque exécution d'agent d'IA compte.
Pas d’appel commercial, pas d’essai à demander. La passerelle demande une ligne.